
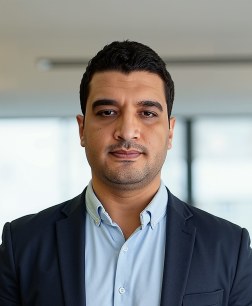
Amine T.
Data Engineer
Han levererar data lakehouses och streaminglösningar i företagsklass för organisationer som Vallourec, RATP och Société Générale, optimerar datapipelines, möjliggör prediktivt underhåll och driver modernisering av analyser över AWS och Azure.
Amine är en Databricks Certified Data Engineer Professional och brinner för att bygga skalbara, kostnadseffektiva och säkra dataekosystem som överbryggar affärsbehov med teknisk excellens.
Huvudsaklig expertis
 AWS4 år
 Apache Spark8 år
 Terraform4 år
 Databricks5 år
Erfarenhet6

Data Architect | Lead Data Engineer
- Designat och utvecklat skalbara ETL-pipelines med hjälp av AWS Glue och Spark Scala för storskalig databehandling.
- Arkitektur och underhåll av AWS-infrastruktur (S3, Glue, Lambda, IAM, Step Functions), vilket säkerställer tillförlitlighet och kostnadseffektivitet.
- Bygga CI/CD-pipelines och genomdriva tekniska standarder genom kodgranskningar och styrningspolicyer.
- Implementerade datakvalitetskontroller, spårning av härkomst och åtkomstkontroller för att upprätthålla dataintegritet och efterlevnad.
- Ledde ett team med fem dataingenjörer och övervakade Terraform-leveranser, Azure DevOps-pipelines och Spark-prestandaoptimering.
- Samarbetade med datavetare för att distribuera ML-modeller som förbättrade tillgångarnas effektivitet och minskade stilleståndstiden.
- Levererade QuickSight-instrumentpaneler som möjliggör säkra affärsinsikter i realtid.
Databricks Python
 SQLTerraform
 DevOps

Data Architect | Lead Data Engineer
- Utformade och implementerade en Data Mesh-arkitektur på Databricks (AWS) och byggde styrda datalager i Glue och Collibra.
- Utvecklade rörledningar för datainmatning och delning i Spark/Scala och PySpark med fullständig CI/CD-automatisering.
- Skapade Databricks jobbautomationsverktyg med Terraform och orkestrerade arbetsflöden via AWS MWAA.
- Utformade datapipelines för prediktivt underhåll och passagerarflödesanalys med hjälp av Kafka, Spark och AWS Glue.
- Implementerat datakvalitetsövervakning med Airflow och Great Expectations, vilket säkerställer hög datatillförlitlighet.
- Samarbetade med datavetare för att operationalisera prognosmodeller för tjänsteoptimering.
AWSDatabricksApache SparkPython Apache Kafka
Data Engineer
- Migrerade produktionsapplikationer från HDP till Cloudera, skapade och konfigurerade flera miljöer för att säkerställa en smidig övergång.
- Utvecklade CI/CD-pipelines och Terraform-jobb för att tillhandahålla och skala virtuella datorer i olika miljöer.
- Stödde teknikteam under hela migreringsfasen och säkerställde minimal driftstopp.
- Utvecklade och distribuerade Spark Scala-bibliotek och orkestrerade produktionsjobb för hög tillgänglighet.
- Utforma och implementera NiFi-pipelines för att ta in data från externa API:er.
- Byggde ramverk för datainmatning och transformation för marknads- och riskdatapipelines med hjälp av Spark och Hadoop.
- Automatiserade datakvalitetskontroller och implementerade spårning av härkomst med Apache Atlas.
- Samarbetade med kvantteam för att förbättra riskmodellens datanoggrannhet och minska latensen i nedströmsanalys.
- Optimerade HDFS och Hive-baserade datasjöar, vilket förbättrar prestanda och lagringseffektivitet.
- Bidrog till automatisering av regelbunden rapportering och säkerställde efterlevnad av Basel III-standarder.
Apache SparkPythonSQL ScalaTerraform

Big Data Developer
- Byggde Spark-baserade datapipelines och ETL-arbetsflöden i Talend och Kafka för rapportering i realtid om reglering och bedrägeribekämpning.
- Utvecklade en AWS-baserad arkitektur, omvandlade CSV-data till Parquet och optimerade Hive-tabeller för prestanda.
- Automatiserade arbetsflöden för distribution med Jenkins och Ansible, vilket förbättrar utvecklingseffektiviteten.
- Skapade Oozie-bundles och Spark Scala-jobb för att implementera affärsregler och hantera data i Cassandra.
- Indexerade data med Solr för att möjliggöra snabba sökfunktioner och stödde produktionsdistribution och övervakning.
Apache SparkPythonApache KafkaSQL Apache Hive

Data Engineer
Lansrod is an IT consulting company specializing in big data, business intelligence, and software engineering projects for enterprise clients.
-
Designed and implemented data warehouse and BI solutions across multiple industries.
-
Built ETL processes in Talend for integrating data from ERP and CRM systems.
-
Developed dashboards and KPIs in Power BI and Tableau for client reporting.
-
Assisted in data lake design and migration to Hadoop clusters.
-
Conducted data audits to ensure consistency and improve reporting accuracy.
Used skills: Talend, Hadoop, Power BI, Tableau, SQL, ETL, Data Warehouse, Business Intelligence
SQL Microsoft Power BI
 ETL
 Tableau
 Hadoop

Junior Data Scientist
AddVolt is a Portuguese clean technology startup providing electric systems for refrigerated vehicles, enabling emission-free transportation.
- Project management.
- Modeling of problems related to Data Science.
- Interpretation of Machine Learning models applied to real situations.
- Pre-processing of spatio-temporal data, definition of concepts related to the problem, selection of the model and its parameters, modification of some performance metrics, and benchmarking of different classification models.
- Creation of visualization tools for the results obtained through interactive maps and a video explaining the work performed.
- Comparison of different results and analysis of the proposed solutions.
- Recommendation of a new algorithm for the allocation of virtual machines.
- Deployment of the designed project.
PythonSQL Machine Learning
 Internet of Things (IoT)
 Microsoft Excel
Ingenjörsexcellens
Alla Data Engineerer som har ansökt till Proxify får ett betyg från 0 till 300 på ingenjörskompetens, en av de fem parametrar vi utvärderar. Detta betyg speglar endast ingenjörskompetens och baseras på intervjuer, hemuppgifter, live-kodningssessioner och/eller prestationer på jobbet. Kurvan visar hur alla utvärderade Data Engineerer är fördelade över det intervallet, var vår accepteringsgräns för denna parameter ligger och var Amine befinner sig.
Score 192 · Top 9% of engineers
Certifikat 3

Issued Oct 2024 - Expires Oct 2026
Databricks
Issued Jul 2018
Credential ID LWJLBZ92VPGH
ScalaIssued Oct 2024 - Expires Oct 2026
DatabricksUtbildning
Sluta bläddra.
Få matchad snabbare.
Prata med en expert och få skräddarsydda matchningar från vårt nätverk på bara 2 dagar.
Tillgång till över 6 000+ experter
Hitta en utvecklare i genomsnitt 2 dagar
Anställ snabbt och enkelt med 94% matchningsframgång