
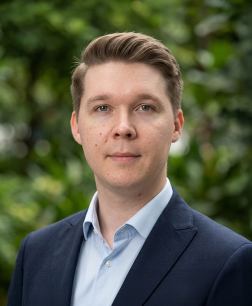
Patryk K.
Senior Data Engineer
Il a livré des solutions Lakehouse prêtes pour la production en utilisant l'architecture Medallion et PySpark sur Databricks, migré des charges de travail SSIS existantes vers Azure Data Factory, et développé des entrepôts de données Azure Synapse pour le reporting réglementaire et les processus d'audit fiscal. Son expérience comprend également les Delta Live Tables (DLT), les pipelines de données en streaming, la génération de SQL pilotée par métadonnées et l'orchestration avec Apache Airflow sur Kubernetes.
Reconnu pour son esprit analytique et son souci du détail, il excelle dans la résolution de défis complexes en ingénierie des données tout en construisant des plateformes de données fiables, évolutives et faciles à maintenir. Il collabore efficacement avec des équipes transverses et livre systématiquement des solutions de haute qualité qui soutiennent les analyses et les prises de décision critiques pour l'entreprise.
Expertise principale
 Data Engineering5 ans
 SQL5 ans
 Databricks3 ans
 Azure Data Factory3 ans
Expérience4
Data Engineer
- Développement de pipelines de données batch et streaming évolutifs sur Azure Databricks à l'aide de PySpark et Spark SQL
- Conception et maintenance de l'architecture Medallion (Bronze, Silver, Gold) et des pipelines Delta Live Tables (DLT)
- Construction de pipelines d'ingestion en temps réel intégrant Debezium CDC avec Kafka
- Gestion de la gouvernance des données et de l'accès sécurisé avec Unity Catalog et Azure Key Vault
- Orchestration des workflows avec Databricks Workflows et gestion des déploiements à l'aide de Databricks Asset Bundles et Git
- Intégration d'API REST et d'Azure Data Lake Storage (ADLS), avec traitement de jeux de données CSV, JSON et Parquet
- Utilisation des Databricks SQL Warehouses pour la validation des données, le dépannage et les requêtes analytiques
 DockerDatabricks
 Apache Spark
 Python
 Kubernetes
Data Engineer
- Contribution au développement d'une plateforme de données open source construite sur des technologies Apache
- Orchestration de pipelines de données avec Apache Airflow s'exécutant sur Kubernetes
- Développement de modèles dbt sur Trino à l'aide de tables Apache Iceberg
- Gestion de pipelines de données sur S3, Hive, Iceberg et Apache Druid
- Traitement d'événements en streaming provenant de Redpanda (compatible Kafka) avec Python
- Travail dans un environnement conteneurisé utilisant Docker et Kubernetes
DockerPython Apache KafkaSQL
 AWS S3
Data Engineer
- Migration de charges de travail SSIS existantes vers Azure Data Factory, avec conception et maintenance de pipelines ETL cloud évolutifs
- Développement de solutions T-SQL pilotées par métadonnées et optimisation des transformations SQL et des processus de chargement de données
- Construction de pipelines Azure Synapse et de procédures stockées pour générer des rapports fiscaux réglementaires JPK à partir des données d'Azure Data Lake
- Développement de pipelines de données par lots dans Azure Databricks à l'aide de PySpark, Spark SQL et Delta Live Tables (DLT)
- Conception de l'architecture Medallion (Bronze, Silver, Gold) et traitement des données CSV, JSON et Parquet stockées dans Azure Data Lake Storage
- Utilisation des Databricks SQL Warehouses pour valider la qualité des données et résoudre les problèmes des pipelines de production
Databricks T-SQLSQLAzure Data Factory
Junior SQL Developer
Oracle Data Warehouse
-
Development and maintenance of a large-scale Oracle data warehouse.
-
Developed and maintained ETL processes using Oracle Data Integrator (ODI) for new and existing mappings.
-
Wrote and optimized PL/SQL stored procedures for data transformation.
-
Designed and maintained Oracle Database objects.
-
Performed data source analysis and supported daily ETL operations.
-
Built OLAP cubes for analytical reporting.
SQL Oracle
 PL/SQL
 ETL
 Oracle Data Integrator
Excellence en ingénierie
Tous les Senior Data Engineers qui ont postulé chez Proxify sont notés de 0 à 300 en excellence en ingénierie, l'un des cinq paramètres que nous évaluons. Ce score reflète uniquement l'excellence en ingénierie, basée sur des entretiens, des exercices à domicile, des sessions de codage en direct, et/ou des évaluations de performance en poste. La courbe montre comment tous les Senior Data Engineers évalués sont répartis sur cette plage, où se situe notre seuil d'acceptation pour ce paramètre, et où se situe Patryk.
Score 188 · Top 11% of engineers
Certificats 1

Issued Jun 2024 - Expires Jun 2026
DatabricksData EngineeringIssued Jun 2024 - Expires Jun 2026
DatabricksData EngineeringÉducation
Arrêtez de naviguer.
Soyez jumelé plus rapidement.
Parlez à un expert et obtenez des correspondances personnalisées de notre réseau en seulement 2 jours.
Accédez à plus de 6 000+ experts
Soyez jumelé avec un développeur en 2 jours en moyenne
Embauchez rapidement et facilement avec un taux de réussite de 94%