
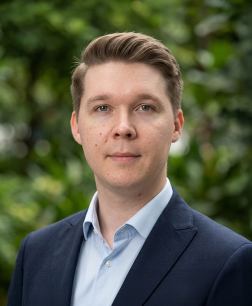
Patryk K.
Senior Data Engineer
Er hat produktionsreife Lakehouse-Lösungen mit der Medallion-Architektur und PySpark auf Databricks bereitgestellt, veraltete SSIS-Workloads zu Azure Data Factory migriert und Azure-Synapse-Data-Warehouses für regulatorische Berichterstattung und Steuerprüfungsprozesse entwickelt. Seine Erfahrung umfasst zudem Delta Live Tables (DLT), Streaming-Datenpipelines, metadatengesteuerte SQL-Generierung und die Orchestrierung mit Apache Airflow auf Kubernetes.
Bekannt für seine analytische Denkweise und sein Auge fürs Detail, zeichnet er sich durch die Lösung komplexer Data-Engineering-Herausforderungen aus und baut dabei zuverlässige, skalierbare und wartbare Datenplattformen. Er arbeitet effektiv mit funktionsübergreifenden Teams zusammen und liefert durchgängig hochwertige Lösungen, die geschäftskritische Analysen und Entscheidungsfindungen unterstützen.
Hauptkompetenz
 Data Engineering5 Jahre
 SQL5 Jahre
 Databricks3 Jahre
 Azure Data Factory3 Jahre
Erfahrung4
Data Engineer
- Entwicklung skalierbarer Batch- und Streaming-Datenpipelines auf Azure Databricks mit PySpark und Spark SQL
- Entwurf und Pflege der Medallion-Architektur (Bronze, Silver, Gold) sowie von Delta-Live-Tables-(DLT)-Pipelines
- Aufbau von Echtzeit-Ingestion-Pipelines mit Integration von Debezium CDC und Kafka
- Verwaltung von Data Governance und sicherem Zugriff mit Unity Catalog und Azure Key Vault
- Orchestrierung von Workflows mit Databricks Workflows sowie Verwaltung von Deployments mittels Databricks Asset Bundles und Git
- Integration von REST-APIs und Azure Data Lake Storage (ADLS) sowie Verarbeitung von CSV-, JSON- und Parquet-Datensätzen
- Einsatz von Databricks SQL Warehouses zur Datenvalidierung, Fehlerbehebung und für analytische Abfragen
 DockerDatabricks
 Apache Spark
 Python
 Kubernetes
Data Engineer
- Mitwirkung an der Entwicklung einer Open-Source-Datenplattform auf Basis von Apache-Technologien
- Orchestrierung von Datenpipelines mit Apache Airflow auf Kubernetes
- Entwicklung von dbt-Modellen auf Trino unter Verwendung von Apache-Iceberg-Tabellen
- Verwaltung von Datenpipelines über S3, Hive, Iceberg und Apache Druid
- Verarbeitung von Streaming-Events von Redpanda (Kafka-kompatibel) mit Python
- Arbeit in einer containerisierten Umgebung mit Docker und Kubernetes
DockerPython Apache KafkaSQL
 AWS S3
Data Engineer
- Migration veralteter SSIS-Workloads zu Azure Data Factory, Entwurf und Wartung skalierbarer Cloud-ETL-Pipelines
- Entwicklung metadatengesteuerter T-SQL-Lösungen sowie Optimierung von SQL-Transformationen und Datenladeprozessen
- Aufbau von Azure-Synapse-Pipelines und gespeicherten Prozeduren zur Erstellung regulatorischer JPK-Steuerberichte aus Daten im Azure Data Lake
- Entwicklung von Batch-Datenpipelines in Azure Databricks mit PySpark, Spark SQL und Delta Live Tables (DLT)
- Entwurf der Medallion-Architektur (Bronze, Silver, Gold) sowie Verarbeitung von CSV-, JSON- und Parquet-Daten im Azure Data Lake Storage
- Einsatz von Databricks SQL Warehouses zur Validierung der Datenqualität und Fehlerbehebung in Produktionspipelines
Databricks T-SQLSQLAzure Data Factory
Junior SQL Developer
Oracle Data Warehouse
-
Development and maintenance of a large-scale Oracle data warehouse.
-
Developed and maintained ETL processes using Oracle Data Integrator (ODI) for new and existing mappings.
-
Wrote and optimized PL/SQL stored procedures for data transformation.
-
Designed and maintained Oracle Database objects.
-
Performed data source analysis and supported daily ETL operations.
-
Built OLAP cubes for analytical reporting.
SQL Oracle
 PL/SQL
 ETL
 Oracle Data Integrator
Excellence en ingénierie
Alle Senior Data Engineers, die sich bei Proxify beworben haben, werden auf einer Skala von 0 bis 300 in technischer Exzellenz bewertet, einem der fünf von uns bewerteten Parameter. Diese Bewertung spiegelt ausschließlich die technische Exzellenz wider, basierend auf Interviews, Heimaufgaben, Live-Coding-Sitzungen und/oder Leistungsbewertungen am Arbeitsplatz. Die Kurve zeigt, wie alle bewerteten Senior Data Engineers in diesem Bereich verteilt sind, wo unsere Akzeptanzschwelle für diesen Parameter liegt und wo sich Patryk befindet.
Score 188 · Top 11% of engineers
Zertifikate 1

Issued Jun 2024 - Expires Jun 2026
DatabricksData EngineeringIssued Jun 2024 - Expires Jun 2026
DatabricksData EngineeringAusbildung
Hör auf zu stöbern.
Lass dich schneller matchen.
Sprechen Sie mit einem Experten und erhalten Sie innerhalb von nur 2 Tagen maßgeschneiderte Matches aus unserem Netzwerk.
Zugriff auf über 6.000+ Experten
Werden Sie im Durchschnitt in 2 Tagen mit einem Entwickler zusammengebracht
Schnell und einfach einstellen mit 94% Übereinstimmungserfolg